

Beispiel für Stammdatenmanagement: Wie aus sechs doppelten Datensätzen drei wurden
// AUF DIESER SEITE 07
- 01 Warum die Zählung immer falsch ist
- 02 Was der Betrieb mit nicht abgeglichenen Daten tatsächlich kostet
- 03 Warum die meisten Stammdatenmanagement-Projekte trotzdem scheitern
- 04 Wie eine Lösung tatsächlich aussieht
- 05 Wo dies in eine größere Datengrundlage passt
- 06 Häufig gestellte Fragen
- 07 Quellen
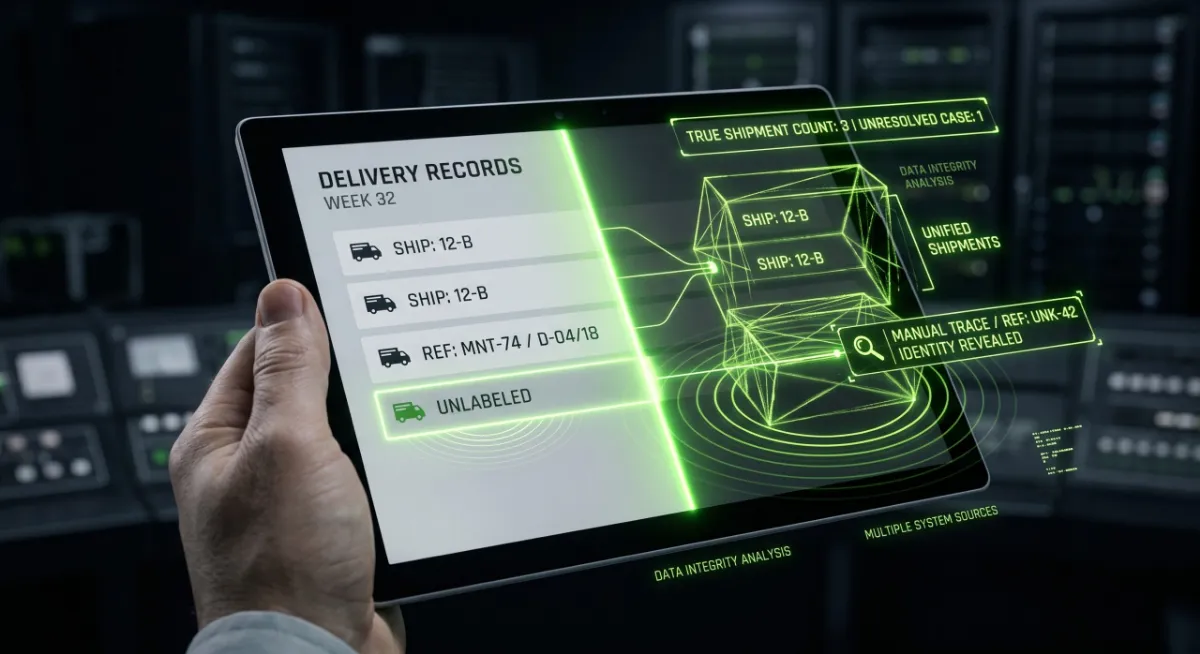
Innerhalb einer Woche gingen sechs Lieferbelege ein. Rein rechnerisch bedeutet das sechs separate Sendungen, sechs Positionen und sechs mögliche Entscheidungen bezüglich des weiteren Vorgehens. Bei genauerer Betrachtung zeigt sich jedoch, dass es sich bei dreien um dieselbe Sendung handelt, die von zwei verschiedenen, nicht miteinander kommunizierenden Systemen doppelt erfasst wurde. Eine vierte Sendung kam ohne jegliches brauchbares Etikett an; sie musste physisch geöffnet und manuell zurückverfolgt werden, bevor man feststellen konnte, was sich darin befand.
Die tatsächliche Anzahl betrug also nicht sechs. Es handelte sich um drei Lieferungen, einen ungelösten Fall, der niemals einer manuellen Untersuchung hätte bedurft, und einen Datensatz, der die ganze Zeit über seine eigene Größe stillschweigend gelogen hatte.
Die meisten Vorgänge sehen bei genauerer Betrachtung genau so aus.
Warum die Zählung immer falsch ist
Daten zu ein und derselben Anwendung – einer Lieferung, einem Lieferanten, einem Produkt – treffen in der Regel aus mehreren Richtungen ein. Eine E-Mail bestätigt die Bestellung. Ein Lieferantenportal erfasst die Sendung. Ein gescannter Lieferschein wird an anderer Stelle abgelegt. Jeder dieser Wege hat sein eigenes Format, seine eigene Person, die die Daten eingibt, und sein eigenes Risiko für Tippfehler, fehlende Felder oder die Erfassung einer Sendung, bevor jemand bemerkt, dass sie bereits eine Stunde zuvor von einem anderen System erfasst wurde.
Peer-Review-Studien zur Genauigkeit manueller Dateneingabe ergaben Fehlerraten von etwa 0,5 % bis 4 % pro Feld, abhängig von der Eingabemethode. Dies gilt selbst für geschultes Personal, das mit standardisierten Formularen arbeitet. Die im Arbeitsalltag gängigsten Methoden – die manuelle Eingabe und die visuelle Kontrolle – lagen dabei im oberen Bereich dieser Spanne (Barchard & Pace, 2011, Computers in Human Behavior ). Diese Spanne ist jedoch nur ein Teil der Wahrheit: Bei unübersichtlichen oder handschriftlichen Quelldokumenten steigen die Fehlerraten unter Zeitdruck weiter an. Die Fehler, die durchrutschen, fallen selten unter die Kategorie der Validierungsregeln; die meisten liegen zwar innerhalb des zulässigen Bereichs für das jeweilige Feld, sind aber dennoch falsch. All dies erfordert keine Nachlässigkeit. Es ist die Folge davon, dass Daten gleichzeitig über mehrere unkoordinierte Kanäle in ein Unternehmen gelangen und niemand überprüft, ob dieselben Daten nicht versehentlich zweimal eingegeben wurden.
Die Benchmark-Studie von APQC zeigt, wo dieser Wert selbst bei Spitzenleistungen liegt: Unternehmen im obersten Viertel der Kreditorenbuchhaltung verzeichnen immer noch 0,8 % Rückbuchungen aufgrund von Duplikaten oder Fehlern bei den jährlichen Auszahlungen. Und das nicht bei den am schlechtesten geführten Unternehmen, sondern bei den am besten geführten. Multipliziert man diesen Prozentsatz mit dem jährlichen Transaktionsvolumen eines mittelständischen Unternehmens, erscheint er nicht mehr als Rundungsfehler.
Was der Betrieb mit nicht abgeglichenen Daten tatsächlich kostet
Das Beispiel mit den sechs Datensätzen ist bewusst klein gehalten, um es anschaulicher zu machen. Die finanzielle Dimension desselben Problems ist jedoch enorm. Gartner beziffert die durchschnittlichen jährlichen Kosten mangelhafter Datenqualität auf 12,9 Millionen US-Dollar pro Unternehmen. IBM schätzt die gesamtwirtschaftlichen Kosten fehlerhafter Daten allein in den USA auf rund 3 Billionen US-Dollar pro Jahr. Beide Zahlen beziehen sich nicht auf einen einzelnen, dramatischen Fehler. Vielmehr geht es um die schleichende Anhäufung kleiner Abstimmungslücken, die sich beispielsweise in drei doppelten Lieferdatensätzen äußern, die erst nach einer Woche auffallen.
Gerade im Bereich der Kreditorenbuchhaltung, wo ständig doppelte und nicht abgeglichene Datensätze auftreten, beziffert das Benchmarking von Ardent Partners die durchschnittlichen Kosten für die Verarbeitung einer einzelnen Rechnung auf 9,40 US-Dollar. Im Vergleich dazu liegen die Kosten bei Unternehmen mit ausgereifter Automatisierung bei etwa 2,78 US-Dollar. Diese Differenz ist fast ausschließlich darauf zurückzuführen, wie viel manuelle Abstimmung nach wie vor pro Rechnung erforderlich ist. Genau diese Differenz sind die direkten, messbaren Kosten, die entstehen, wenn der in diesem Beitrag beschriebene Schritt „Lesen, Bereinigen und Neuladen“ ausgelassen wird.
Warum die meisten Stammdatenmanagement-Projekte trotzdem scheitern
Ein oft übersehener Aspekt ist: Der Kauf einer Master-Data-Management-Plattform (MDM) löst das Problem nicht automatisch. Studien zu MDM-Implementierungen zeigen eine Misserfolgsrate von bis zu 76 %, wobei die meisten Projekte scheitern, bevor sie überhaupt produktiv eingesetzt werden können. Das ist eine erstaunlich hohe Zahl für eine Branche mit einem so klaren und gut dokumentierten Problem.
Die am häufigsten genannten Gründe sind nicht technischer Natur. Es handelt sich um einen fehlenden oder unzureichenden Business Case, die Behandlung von MDM als IT-Initiative anstatt als operative Maßnahme und eine Einführung, die sich auf die „Bereinigung aller Daten“ konzentriert, anstatt auf eine konkrete Entscheidung, die das Unternehmen tatsächlich treffen muss, um bessere Ergebnisse zu erzielen. Anders ausgedrückt: Unternehmen kaufen das Tool, bevor sie die eigentliche Ursache ihrer Datenabgleichslücken diagnostizieren, und wundern sich dann, warum eine Plattform, die auf einem unerkannten Problem aufbaut, dieses nicht löst.
Das ist dasselbe Fehlermuster, das wir generell bei KI-Initiativen beobachten, nicht nur bei MDM. Technologien, die vor der Diagnose angeschafft wurden, bleiben oft ungenutzt oder werden nur halb eingesetzt, weil sie auf eine Problemkategorie und nicht auf das tatsächliche Problem des Betriebs zugeschnitten waren. Eine Master-Data-Management-Plattform kann Datensätze deduplizieren. Sie kann Ihnen aber nicht sagen, welche Abstimmungslücke die höchsten Kosten verursacht oder welche Entscheidung in Ihrem Betrieb von der Korrektheit dieses spezifischen Datensatzes abhängt. Das ist eine Frage der Diagnose, keine Softwarefunktion.
Wie eine Lösung tatsächlich aussieht
Das erfolgversprechende Muster ist nicht „alles genauer prüfen“, da dies bei mehr als einer Handvoll Datensätzen pro Tag nicht praktikabel ist. Es ist vielmehr eine Pipeline, die drei Dinge automatisch erledigt, bevor die Daten überhaupt ein System erreichen, das darauf angewiesen ist:
- Lesen Sie alle eingehenden Daten unabhängig vom Format – ob strukturierter Datenfeed, gescanntes Dokument oder manuell eingegebene Zeile –, ohne dass eine Person vorher entscheiden muss, ob sich eine Überprüfung lohnt.
- Bereinigen Sie die Daten. Gleichen Sie neue Datensätze mit bereits bekannten ab, kennzeichnen Sie Duplikate, anstatt sie stillschweigend als neue Einträge zu laden, und heben Sie alles hervor, was nicht eindeutig aufgelöst werden kann, wie z. B. eine nicht etikettierte Sendung, um eine schnelle manuelle Überprüfung anstelle einer ergebnisoffenen Untersuchung durchzuführen.
- Neu laden, verifiziert. Sobald ein Datensatz geprüft, von Duplikaten befreit und korrekt identifiziert wurde, wird er mit einer nachvollziehbaren Verbindung zu seiner Quelle wieder in die Systeme eingespeist, die davon abhängen (ERP, Planung, Beschaffung).
Richtig umgesetzt, läuft dies kontinuierlich und nicht nur als einmaliges Bereinigungsprojekt. Gartners Forschung zu Unternehmen mit ausgereiften MDM-Praktiken zeigt messbare Ergebnisse dieser kontinuierlichen Datenabstimmung: bis zu 20 % höhere Datengenauigkeit und durchschnittlich 45 % weniger manueller Aufwand für die Datenabstimmung selbst. Letzteres ist besonders wichtig: weniger Mitarbeiter, die ihre Woche mit der manuellen Nachverfolgung unbeschrifteter Sendungen verbringen müssen – und nicht nur sauberere Daten auf einem Dashboard.
Wo dies in eine größere Datengrundlage passt
Diese Art von Datenabgleichslücke ist Teil eines Musters, das wir generell in mittelständischen Unternehmen beobachten: Die Daten sind zwar vorhanden, aber oft dupliziert, verstreut oder nicht mit den Systemen verbunden, die sie benötigen. Besonders im Einkauf tritt dieses Problem häufig auf, da hier die größte Menge externer Daten aus verschiedenen Quellen in das Unternehmen gelangt. Wenn dieser Bereich in Ihrem Unternehmen am stärksten betroffen ist, lohnt es sich, auch den Artikel darüber zu lesen, wie KI den Einkauf effizienter gestaltet .
Unsere Methode beginnt mit der präzisen Identifizierung von Abstimmungslücken wie dieser in einem Betriebsablauf und deren Auswirkungen auf die Entscheidungen, bevor wir eine Plattform empfehlen. Diese diagnoseorientierte Vorgehensweise entscheidet darüber, ob ein MDM-Projekt scheitert oder nicht. DataCore ist so konzipiert, dass es die Pipeline aus Lesen, Bereinigen und Neuladen kontinuierlich ausführt und ERP-, CRM-, Tabellenkalkulations- und eingehende Betriebsdaten in einer strukturierten, nachvollziehbaren Ebene vereint. Optional kann die gesamte Infrastruktur lokal betrieben werden, wenn höchste Datensicherheit erforderlich ist.
Häufig gestellte Fragen
Was ist ein Beispiel für Stammdatenmanagement in der Praxis? Ein konkretes Beispiel sind doppelte oder falsch gekennzeichnete Datensätze, die aus verschiedenen Quellen – einer E-Mail, einem Lieferantenportal, einem gescannten Dokument – in einen Vorgang gelangen und automatisch abgeglichen, dedupliziert und zu einem einzigen vertrauenswürdigen Datensatz pro realer Entität zusammengeführt werden, bevor sie in ein Stammdatensystem gelangen.
Warum scheitern Master-Data-Management-Projekte so häufig? Untersuchungen zu MDM-Implementierungen beziffern die Misserfolgsrate auf bis zu 76 %, am häufigsten aufgrund eines schwachen oder fehlenden Business Case, der Tatsache, dass die Initiative als IT-Projekt und nicht als operatives Projekt konzipiert wurde, und der Tatsache, dass Plattformen eingeführt werden, ohne vorher zu diagnostizieren, welche spezifische Abstimmungslücke dem Unternehmen tatsächlich Kosten verursacht.
Wie hoch sind die Kosten mangelhafter Datenabstimmung tatsächlich? Gartner schätzt die durchschnittlichen Kosten schlechter Datenqualität auf 12,9 Millionen US-Dollar pro Unternehmen und Jahr. Insbesondere im Bereich der Kreditorenbuchhaltung treiben nicht abgeglichene und doppelte Datensätze die durchschnittlichen Kosten der Rechnungsverarbeitung auf rund 9,40 US-Dollar – mehr als das Dreifache der Kosten in Unternehmen mit ausgereiften Abstimmungssystemen.
Verschwindet dieses Problem, sobald ein KI-System im Spiel ist? Nein. KI-Systeme verarbeiten die ihnen bereitgestellten Daten, ohne die übliche Plausibilitätsprüfung durchzuführen. Ein doppelter oder falsch gekennzeichneter Datensatz, der zuvor nicht beanstandet wurde, wird auch von einem KI-Modell nicht erkannt, sondern einfach bedenkenlos verwendet.
Was ist der erste Schritt zur Behebung dieses Problems? Man muss herausfinden, welche konkreten Entscheidungen derzeit auf der Grundlage nicht abgeglichener oder doppelter Daten getroffen werden, und nicht auf der Grundlage des gesamten Datensatzes auf einmal. Anschließend muss die Read-Clean-Reload-Pipeline so aufgebaut werden, dass diese Lücke zuerst geschlossen wird.
Quellen
- Gartner, „Datenqualität: Warum sie wichtig ist und wie man sie erreicht“ (Kosten mangelhafter Datenqualität: durchschnittlich 12,9 Mio. US-Dollar pro Jahr). gartner.com/en/data-analytics/topics/data-quality
- IBM, „Die wahren Kosten mangelhafter Datenqualität“ (wirtschaftliche Kostenschätzung: ca. 3 Billionen US-Dollar pro Jahr in den USA). ibm.com/think/insights/cost-of-poor-data-quality
- Profisee, „Überzeugende Argumentation für Master Data Management“ (Studie zur Misserfolgsrate von MDM-Programmen). profisee.com/blog/making-an-effective-business-case-for-master-data-management
- Semarchy, „Stammdatenmanagement-Statistiken: Was Sie wissen müssen“ (Gartner-Daten zu Genauigkeit, Effizienz und Abgleichsaufwand). semarchy.com/blog/master-data-management-statistics-what-you-need-to-know
- Transformance.ai, „Kosten pro Rechnung: Benchmarks für Kreditoren- und Debitorenbuchhaltungsteams bis 2026“ (Benchmarks für die Rechnungsverarbeitung von Ardent Partners). transformance.ai/blog-posts/cost-per-invoice-benchmarks
- Barchard, K. A. & Pace, L. A. (2011), „Vermeidung menschlicher Fehler: Der Einfluss von Dateneingabemethoden auf die Datengenauigkeit und statistische Ergebnisse“, Computers in Human Behavior , 27(5), 1834–1839 (Peer-Review-Studie zum Vergleich von Dateneingabemethoden und den daraus resultierenden Fehlerraten). doi.org/10.1016/j.chb.2011.04.004
- Reconciler AI, Benchmark-Daten (von APQC ermittelte Quote doppelter/fehlerhafter Auszahlungen). reconciler-ai.com/benchmarks
Möchten Sie wissen, wie viele Ihrer betrieblichen Daten derzeit doppelt vorhanden oder ungelöst sind? Buchen Sie eine kostenlose KI-Analyse .
URSPRÜNGLICH ERSCHIENEN
Dieser Artikel erschien zuerst auf embiggenx.com